Preferred Networks(PFN)と米Tenstorrentは2026年10月20日、生成AIの学習および推論に向けたプロセッサ基盤とシステムの共同開発を開始しました。両社は新エネルギー・産業技術総合開発機構(NEDO)の公募事業に採択され、2031年度までに光電融合技術と先端パッケージングを統合した次世代AIインフラの実用化を目指します。
NEDO公募採択から見る日米連合の開発体制とロードマップ
本事業は、NEDOが推進する「ポスト5G情報通信システム基盤強化研究開発事業/先端半導体製造技術の開発」における公募テーマ「(f8)光電融合技術を実装したxPU設計開発【GX】」に採択されたものです。実施期間は2026年度から2031年度までの約6年間にわたり、研究開発から実用化検証、事業化までを一体で進めます。
開発の役割分担として、TenstorrentがRISC-Vアーキテクチャに基づくCPUの開発を担当し、PFNが高効率な行列演算を担うAIアクセラレータの開発を主導します。さらに、チップ間やノード間を低消費電力かつ広帯域で結ぶ光電融合技術の実装、先端パッケージング技術を用いたシステム化技術については、両社が共同で開発を進める枠組みです。
国内の研究機関および大学も再委託先として参画しています。東京大学、神戸大学、東洋大学、海洋研究開発機構(JAMSTEC)、日本原子力研究開発機構(JAEA)、そしてテンストレントジャパンが連携し、学術研究と産業実装の双方から設計を支援します。
以下の表は、本開発プロジェクトに関わる主要組織とそれぞれの役割をまとめたものです。
| 組織名 | プロジェクトにおける主な役割 | コア技術・関連実績 |
|---|---|---|
| Preferred Networks(PFN) | AIアクセラレータ開発、システム化技術 | 専用チップ「MN-Core」、国産LLM「PLaMo」 |
| Tenstorrent | RISC-V CPU開発、システム化技術 | CPU「Ascalon」、AIプロセッサ「Blackhole」 |
| NEDO | 公募事業の採択および研究開発費の助成 | ポスト5G・先端半導体製造技術開発事業 |
| 東京大学 / 神戸大学 / 東洋大学 | 学術研究支援、アーキテクチャ最適化 | 神戸大学は初期MN-Coreの共同開発元 |
| JAMSTEC / JAEA | ハイパフォーマンス計算における検証と要件定義 | 大規模数値計算・科学技術計算の運用知見 |
PFNは独自開発のAIアクセラレータ「MN-Core」シリーズにおいて、演算器を行列計算に特化させることで、過剰なキャッシュメモリや制御回路を削ぎ落とす設計を一貫して採用してきました。スーパーコンピュータの省電力性能ランキング「Green500」では、MN-Coreを搭載したシステム「MN-3」が世界第1位を計3回(2020年6月、2021年6月、2021年11月)獲得しています。
PFNは次世代AI推論特化プロセッサ「MN-Core L1000」の開発を2024年11月に公表しており、提供開始予定を2027年としています。L1000を組み込んだシステムでは、パラメータ数700億(70B)規模のLLMにおいて毎秒500〜1000トークンの推論速度を達成する仕様です。さらに今回のTenstorrentとの長期共同開発を通じて、単一ノードかつ128Kコンテキスト長の1兆(1T)パラメータモデル推論を、毎秒約500トークンで処理する将来世代の基盤確立を狙います。
一方のTenstorrentは、ジム・ケラー氏がCEOを務める半導体設計企業です。オープンな命令セットアーキテクチャであるRISC-Vを採用した高性能CPUコア「Ascalon」や、独自インターコネクトを備えたAIプロセッサ「Blackhole」を製品化しています。同社は2026年10月19日にシリーズEラウンドで15億米ドルを調達し、評価額は62億米ドルに達しました。日本国内ではRapidusと2nmロジック技術によるエッジAIアクセラレータの開発連携を進めており、国内エコシステムとの結びつきを深めています。
以下の表は、本発表に至る関連企業の動きを時系列でまとめたものです。
| 年月 | 企業・機関 | 出来事 |
|---|---|---|
| 2024年11月 | PFN | 次世代AI推論特化プロセッサ「MN-Core L1000」の開発計画を発表 |
| 2025年1月 | PFN / Rapidus / さくらインターネット | 省電力な国産AIインフラ実現に向けた基本合意を締結 |
| 2025年12月 | NVIDIA / Groq | NVIDIAがGroqの推論技術に関する非独占ライセンスを約200億米ドルで取得 |
| 2026年8月 | OpenAI / Cerebras | OpenAIがCerebrasと提携し「GPT-5.6 Sol」の高速推論モードを提供開始 |
| 2026年10月19日 | Tenstorrent | シリーズEで15億米ドルを調達(評価額62億米ドル) |
| 2026年10月20日 | NEDO / PFN / Tenstorrent | NEDO先端半導体事業に採択、光電融合AIプロセッサの共同開発を発表 |
参考記事: チップレット設計とは?SoC限界を突破する技術的必然性と導入の投資分岐点を徹底解説
メモリウォールを破るアーキテクチャと光電融合の実装条件
LLMの推論処理において処理遅延を決定づける要因は、純粋な浮動小数点演算能力(FLOPS)ではなく、メモリから重みデータを読み出す「メモリ帯域幅」の限界、いわゆるメモリウォールです。自己回帰的なトークン生成では、1トークンを出力するたびに入力シーケンス全体のキー・バリュー(KVキャッシュ)とモデルパラメータをメモリからロードする必要があります。
既存のGPUシステムは広帯域メモリ(HBM)をシリコンインターポーザ上に実装することで帯域を確保してきました。しかし、HBM自体の供給不足と高価格、さらにはチップ間を電気配線で接続する際の伝送損失と発熱が、システム全体の大規模化を制限しています。
この制約に対し、PFNとTenstorrentの連合は「専用アクセラレータによる高効率演算」「チップレット構成による柔軟なスケーリング」「光電融合による配線抵抗の排除」という3つのアプローチで対抗します。
従来のGPU基盤(電気配線 + HBM依存):
[ GPU Core ]  [ HBM ]
       ||
  ノード間通信 (InfiniBand / 銅線・光トランシーバ変換負荷)

本プロジェクトが目指すアーキテクチャ(光電融合 + チップレット):
[ RISC-V CPU (Ascalon) ]  [ AIアクセラレータ (MN-Core) ]
                                                   ||
                                           [ 光電融合エンジン ]
                                                   || (光導波路・光ファイバー)
                                     超低遅延・高帯域ノード間直結
PFNのMN-Coreアーキテクチャは、汎用GPUが備えるハードウェアキャッシュ制御や分岐予測回路を徹底的に削ぎ落とし、コンパイラが演算器へのデータ供給を静的にスケジューリングする構造をとります。これによりシリコン面積あたりの演算器密度を高め、ワットあたりの処理性能を極大化させます。
一方、CPU側にTenstorrentの高性能RISC-Vコアを採用することで、ホスト制御やデータ前処理における命令セットのオープン性を確保します。プロプライエタリなx86アーキテクチャへの依存を排除し、アクセラレータと密結合したヘテロジニアス構成を構築しやすい環境を整えます。
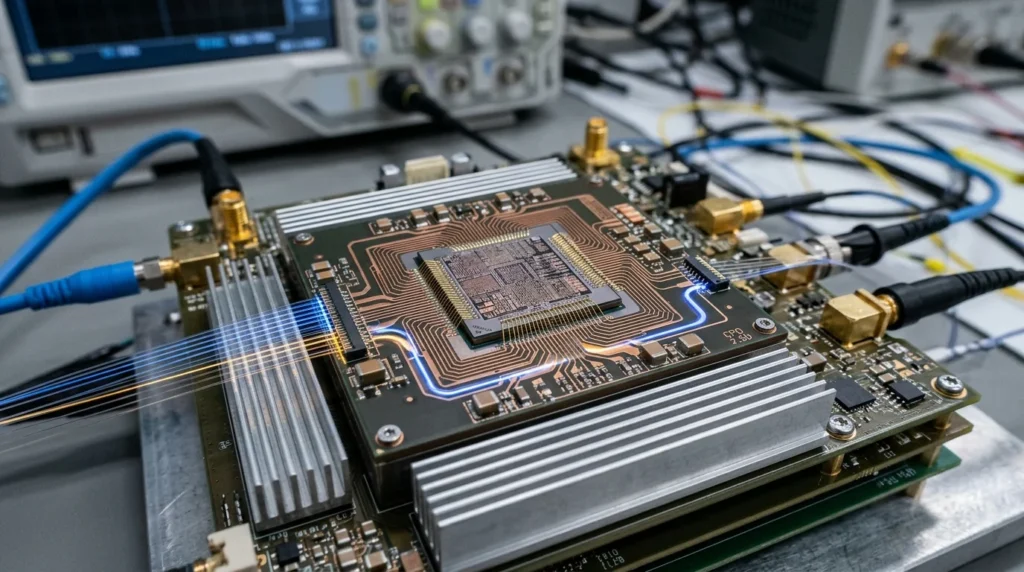
両社を統合する核となるのが光電融合技術です。チップ間およびノード間のインターコネクトに光信号を直接利用することで、従来の銅線配線で問題となっていたRC遅延と誘電損失を抑制します。大容量データを低消費電力で長距離伝送できるため、物理的に分散した複数チップをあたかも単一の巨大プロセッサであるかのように動作させることが可能になります。
ただし、2031年度の事業化に向けては、以下の技術的課題をクリアする必要があります。
第一に、光電融合モジュールのコパッケージ(CPO: Co-Packaged Optics)における歩留まりの確立です。微小な光導波路とシリコンフォトニクス素子、電子回路をミリメートル以下の精度でパッケージングする際、熱膨張係数の差による位置ズレや光結合損失を許容値内に抑えなければなりません。
第二に、コンパイラおよびソフトウェアスタックの成熟度です。NVIDIAの牙城を支えるCUDA環境に対し、PFNの専用コンパイラとTenstorrentのソフトウェア「TT-Buda」やオープンソース開発環境を統合し、主要なAIフレームワーク(PyTorchなど)からコードの改変なしにモデルを展開できる実行環境を構築することが必須条件となります。
参考記事: AI半導体の演算効率を10倍に高める技術とは?3D積層・光電融合の実用化ロードマップと鍵となる技術
推論特化チップの台頭と半導体サプライチェーンの再編
生成AIの活用フェーズが基盤モデルの事前学習から実サービス運用(推論)へ移行するにつれ、推論基盤のコスト構造とエネルギー消費がデータセンター事業者の投資対効果を左右する要因となっています。この市場環境の変化を受け、大手プレイヤーは特定用途向けアクセラレータの確保へ巨額の投資を行っています。
米NVIDIAは2025年12月、推論特化型プロセッサ(LPU)を開発する米Groqの超高メモリ帯域技術に対する非独占ライセンスを約200億米ドルで取得しました。Groqの創業陣を取り込み、次世代システム「Vera Rubin」へSRAM直結型アーキテクチャの知見を統合する動きを見せています。また、米OpenAIは2026年8月、ウエハースケールエンジンを手がける米Cerebrasと提携し、毎秒最大750出力トークンを達成する「GPT-5.6 Sol Ultrafast」モードの提供を開始しました。
各社の推論向けアプローチを比較したものが以下の表です。
| 開発元 / 製品 | アーキテクチャ特徴 | メモリ方式 | 公表された推論性能 |
|---|---|---|---|
| PFN / Tenstorrent(本事業) | 行列演算特化 + RISC-V + 光電融合 | チップレット連携 / 超広帯域構成 | 70Bモデルで500〜1000t/s(将来世代1Tモデルで約500t/s) |
| Cerebras(CS-3) | 単一ウエハー上にコアとメモリを集約 | オンチップSRAM(44GB/ウエハー) | GPT-5.6 Solで最大750t/s(標準比最大14倍) |
| NVIDIA(Groqライセンス統合) | GPUアーキテクチャにSRAM直結型技術を併用 | HBM + SRAM併用型 | Groq単体で毎秒数千トークン規模の低遅延推論 |
| 汎用GPU(従来型) | 汎用並列演算コア | HBM3e / HBM4 | 70Bモデルで数十〜100t/s前後(標準構成) |
この潮流は、半導体設計企業やデータセンター事業者、AIモデル開発企業に明確な影響を与えます。
半導体設計分野では、学習市場を独占してきた汎用GPUに対し、推論処理に特化した専用チップがコストパフォーマンスで優位に立つ領域が拡大しています。市場調査会社IDCが2026年10月に発表したデータによると、中国データセンター向けAIチップ市場において、2026年上半期の特定用途向けAIアクセラレータ出荷台数(101万6000個)が汎用GPU(99万1000個)を逆転しました。同市場におけるNVIDIAのシェアは前年同期から34%まで低下しており、単一アーキテクチャへの依存から多様なチップの併用へシフトが進んでいます。
ネットワークおよびインターコネクト機器の分野では、光電融合の導入によりデータセンター内部のケーブリング構造が変わります。従来の電気式トランシーバを介した階層型ネットワークから、チップ間を光導波路で直結するメッシュ構造への移行が促され、光受動部品やシリコンフォトニクス製造ファウンドリの需要が拡大します。
フロンティアモデルを開発する企業にとっては、毎秒1000トークン規模の推論速度が実用化されることで、エージェント型AIによるマルチステップの思考プロセス(Reasoning)や、10万トークンを超える長文コンテキストのリアルタイム処理が運用可能なコスト内に収まるようになります。
参考記事: NVIDIA Groq 3 LPXの量産開始がもたらす推論基盤の地殻変動
技術責任者が注視すべきハードウェア選定のKPI
生成AIインフラを統括する技術責任者や事業推進者は、2031年のNEDO事業完了を待つことなく、推論基盤の調達戦略を見直す局面にあります。特に、以下の3つの指標(KPI)をモニタリングし、自社ワークロードに最適なチップ選定の分岐点を設定する必要があります。
1つ目の指標は「100万トークンあたりの推論消費電力(Wh/M-tokens)」です。
モデルの大規模化に伴い、データセンターの契約電力容量が処理能力の上限を決定づけるケースが増加しています。単なるFLOPS値ではなく、実運用時の消費電力量あたりのトークン生成量を評価し、PFNの「L1000」やTenstorrentの「Blackhole」が既存GPU対比でどの程度の改善を示すかを計測する必要があります。
2つ目の指標は「単一コンテキスト長128K環境におけるTTFT(Time To First Token)とスループット」です。
長文ドキュメントの解析やコード生成エージェントでは、最初のトークンが出力されるまでのレイテンシと、その後の生成速度がUXと業務生産性を直結して左右します。PFNが掲げる「1Tモデルで約500トークン/秒」という性能目標が部分的にでも前倒しで達成されるかどうかが、オンプレミス型推論ノード導入の判断材料になります。
3つ目の指標は「既存フレームワークからの移植工数(人月)」です。
ハードウェア性能がいかに優れていても、独自の開発環境への移行コストが高ければTCO(総所有コスト)は悪化します。PyTorchなどの主要ライブラリからTenstorrentのTT-BudaやPFNの開発環境へ、コード変更なしでモデルをコンパイルできるカバー率の進捗を定期的に評価することが求められます。
次世代推論インフラの構築に向けた移行計画
PFNとTenstorrentによる共同開発は、推論処理におけるメモリ帯域幅の不足と電力密度の壁を、RISC-V、専用アクセラレータ、光電融合の垂直統合によって打破しようとする試みです。事業責任者およびインフラ設計担当者は、以下のステップで次世代推論インフラへの対応を進めることが推奨されます。
- 推論ワークロードのプロファイリング
自社で稼働させているAIサービスにおいて、メモリ帯域律速となっているモデル(70B以上のパラメータを持つLLM等)のコスト比率を算出し、GPUクラスタにかかる月額費用を可視化する。
- チップレットおよび光電融合ロードマップの追跡
2027年提供予定のMN-Core L1000のベンチマーク結果、およびRapidusの2nm製造ラインとTenstorrentの連携進捗を追い、国内サプライチェーンを活用したオンプレミス環境の実現性を検証する。
- オープンアーキテクチャ検証環境の確保
RISC-Vベースの計算環境や特定用途向けNPUのテスト環境をPoC(概念実証)として小規模に立ち上げ、プロプライエタリな開発環境に依存しないパイプライン設計の検証を開始する。
出典: ITmedia AI+
出典: Preferred Networks プレスリリース
出典: NEDO 実施体制決定公示