Microsoft(マイクロソフト)は2026年11月19日、USB4ケーブルで接続した複数のWindows PC間でメモリを直接相互共有し、大規模言語モデルを分散実行する新技術「RDMA over USB4」の開発者向けプレビューを発表しました。専用GPUサーバーの調達やデータセンターの確保が難しい日本国内のエンタープライズや研究機関にとっても、機密データを社外に出さずに2000億パラメータ級の基幹AIをローカル運用できる現実的な選択肢となります。
専用ネットワーク機器を不要にする「RDMA over USB4」の実証データ
複数台のコンピューティングユニットを束ねて大規模AIモデルを推論させる環境では、ノード間の通信帯域と遅延が全体の処理性能を決定づけます。これまではInfiniBand(インフィニバンド)や100GbE以上の高速RoCE(RDMA over Converged Ethernet)環境を構築するために、高価なネットワークスイッチや専用NIC(ネットワークインターフェースカード)の導入が前提とされてきました。
今回発表されたRDMA over USB4は、市販のUSB4ケーブルでノード同士を直結することにより、専用スイッチを介さずにCPUをバイパスしたリモートメモリアクセスを実現します。従来のUSB4経由Ethernet(UDP)通信と比較して、小容量メッセージの往復遅延は約4分の1に短縮されました。
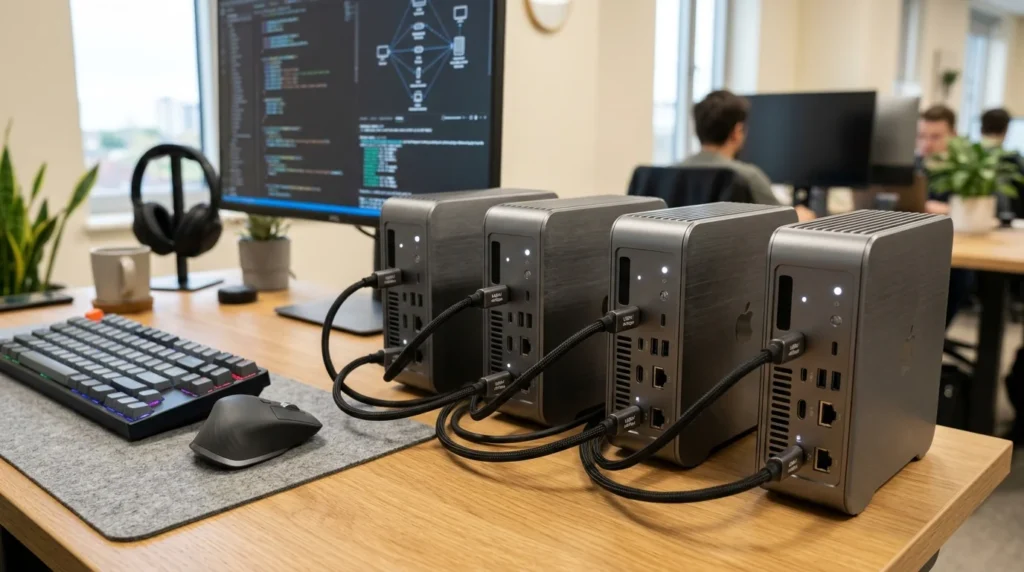
Microsoftおよびハードウェア各社が公開した動作検証データでは、ハイエンドGPUサーバーを用いずに、デスクトップ向けやモバイル向けの統合SoCを複数台連携させて巨大な推論クラスタを成立させています。
| 構成ハードウェア | ノード数 | 実行AIモデル(パラメータ数) | 推論スループット |
|---|---|---|---|
| AMD Ryzen AI Max+ 395 搭載ミニPC | 3台 | Qwen3-235B-A22B(2350億) | 約22 tokens/sec(AMD測定値) |
| AMD Ryzen AI Max+ 395 搭載ミニPC | 3台 | Qwen3-235B-A22B(2350億) | 約18.5 tokens/sec(MSラボ測定値) |
| Intel Core Ultra Series 3 搭載PC | 4台 | GPT-OSS-120B(1200億) | 約54 tokens/sec |
AMD(アドバンスト・マイクロ・デバイセズ)の上級副社長兼最高ソフトウェア責任者であるAndrej Zdravkovic氏は、クラスタリングがローカルAIの可能性を切り拓く開発者体験において極めて重要であると表明し、Microsoftのドライバー開発を全面的に支援する姿勢を示しています。
本技術の発表に先立ち、ハードウェアベンダー側でも小型ハードウェアを束ねる試みが先行していました。2025年12月にはMINISFORUM(ミニスフォーラム)が北京のイベントで「MS-S1 MAX」4台をUSB4で連結し、6710億パラメータの「DeepSeek-R1」推論デモを実施しました。2026年10月に幕張メッセで開催された「Japan IT Week 秋 2026」でも、次世代SoCを搭載した小型PC4台による分散AI動作が実演され、PCハードウェアの連結構造は現実的な推論基盤として確立されつつあります。
参考記事: AI推論インフラとは?CTOが知るべきアーキテクチャ設計とROI最大化戦略
DMAリングの直接制御とNetworkDirectによるアーキテクチャ刷新
なぜ汎用インターフェースであるUSB4を通じて、サーバーグレードの分散推論が可能になったのか。その要因は、WindowsのOSカーネル内部におけるネットワークスタックの迂回設計にあります。
ネットワークスタックを完全バイパスする仕組み
通常のTCP/IPやUDP通信では、パケットの送受信ごとにCPU割り込みが発生し、OSカーネルのメモリバッファとアプリケーションのメモリ領域間でデータの二重コピーが行われます。これがノード間通信における遅延とCPUリソース逼迫の主因でした。
RDMA(Remote Direct Memory Access)は、相手先PCのメインメモリへ直接読み書きを行うことでCPUの介入を排除します。Windowsには従来、サーバー向けInfiniBandや高速Ethernetアダプター向けに「NetworkDirect」と呼ばれるカーネルインターフェースが存在していました。今回の新技術では、USB4ホストルーターが内部に持つDMA(Direct Memory Access)リングを直接叩くNetworkDirectプロバイダーがソフトウェアとして新規実装されています。
このプロバイダーを経由することで、ユーザー空間で動作する推論エンジン(llama.cppなど)が、OSのプロトコルスタックを一切介さずに相手側PCの統一メモリ(Unified Memory)へテンソルデータを送り込めるようになりました。
SOTA分散推論技術との比較
クラスタ構築に用いられる従来のインターコネクトと、USB4による新アプローチの技術的比較は下表の通りです。
| 項目 | InfiniBand / RoCE (400Gbps) | 一般的なEthernet (10Gbps) | RDMA over USB4 (40Gbps〜80Gbps) |
|---|---|---|---|
| スイッチ機器 | 専用高速スイッチが必須 | L2/L3スイッチが必要 | 不要(ケーブルによる直接連結) |
| CPU負荷 | 極小(ゼロコピー転送) | 高(プロトコルスタック処理) | 極小(NetworkDirect経由のDMA) |
| 導入コスト | 数百万円〜数千万円 | 数十万円 | ケーブル代のみ(数万円) |
| 最適な用途 | 大規模クラスタの学習・推論 | 一般オフィスのデータ共有 | オフィス・研究室の小規模推論 |
実装に向けた技術的必須条件
RDMA over USB4は手軽なケーブル接続を実現する一方、運用にはハードウェアとソフトウェア双方の前提条件が存在します。
第一に、接続トポロジの制約です。スイッチを介さないデイジーチェーン接続(数珠つなぎ)またはポイント・ツー・ポイント接続となるため、各ノードには最低2系統以上の独立したUSB4コントローラーが求められます。単一コントローラーから複数ポートを出しているハブ経由の接続では帯域が半減し、推論のテンソル並列処理においてレイテンシボトルネックが生じます。
第二に、メモリ帯域の確保です。AMDのRyzen AI Max+シリーズのように広帯域なLPDDR5XメモリをCPU・GPU共有で持つ統合アーキテクチャでなければ、転送されたテンソルを高速に演算器へ流し込めません。
現在は開発者プレビュー段階であり、「Experimentalチャネル(Future Platforms)」のWindows Insiders向けに先行配信が予定されています。実務での運用には、Windows Insiderビルドの適用と、対応するオープンソースのllama.cppビルド環境の整備が前提条件となります。
参考記事: GPUクラスタの仕組みと構築戦略|CTOが押さえるべき最前線と2030年の未来
日本企業におけるオンプレミス推論基盤の再設計
本技術の登場は、日本国内のエンタープライズ企業が抱える計算資源調達の課題に対して、具体的な解決策を提示しています。
高額GPUサーバーの代替による調達リードタイム短縮
現在、エンタープライズ向けのサーバー用GPUは世界的な需要集中により、発注から納品まで数ヶ月から半年以上のリードタイムを要するケースが少なくありません。価格面でも1台あたり1000万円を超える投資が必要となるため、PoC(概念実証)段階での稟議承認が大きな壁となっています。
ミニPCや一般的なワークステーションを3〜4台組み合わせる構成であれば、初期投資を100万〜200万円程度に抑えつつ、家電量販店や通常のPC調達ルートで即座に機材を揃えられます。Ryzen AI Max+ 395搭載ミニPC 3台の構成で2350億パラメータのオープンモデルが約22トークン/秒で動作する事実は、単一タスクの社内チャットボットやコード生成用途において実用に耐えうるスループットです。
閉域網での運用と物理スペースの制約解消
金融・医療・製造業の研究開発部門など、営業秘密や個人情報保護の観点からクラウドAPIの利用が厳しく制限される現場において、オンプレミス環境でのLLM稼働は必須要件となっています。
しかし、日本のオフィス環境や地方拠点の工場現場では、高重量で爆音を伴い、200V電源と専用空調を要する19インチラックマウントサーバーの設置場所を確保できません。ミニPCをUSB4で直結するクラスタ構成は、100Vの標準家庭用コンセントから電源を取ることができ、執務室の片隅やデスク上でも静音稼働させることが可能です。
残された導入障壁と実務上の注意点
このアプローチを採用するにあたっては、システム管理上の特有な課題を認識しておく必要があります。
- 障害発生時の冗長性: 1台のPCがOSクラッシュや熱暴走で停止した場合、クラスタ全体の推論プロセスが停止します。エンタープライズサーバーのような冗長電源やECCメモリ、ホットスワップ機構は民生用PCには備わっていません。
- 管理ツールの不足: 現在の検証環境はオープンソースのllama.cppなどを手作業で構成する段階にあり、Kubernetes等と統合されたクラスタ管理フレームワークは未成熟です。
- 物理的な配置限界: USB4パッシブケーブルの最大長は約0.8m〜1m程度に制限されます。ノード間を離して設置する場合は、高価なアクティブ光ケーブル(AOC)の選定が必須となります。
参考記事: エッジAI推論の仕組みと導入基準|クラウドとの違いからセキュリティ対策まで徹底解説
推論基盤の選定において次に取るべきアクション
RDMA over USB4は、AI推論インフラの設計において「超高額サーバー単体」から「低コストなコモディティ機器の連結」という選択肢を加えました。インフラ設計者や技術責任者は、自社のAI投資計画に以下の手順で反映させることが推奨されます。
- 保有する機密データの重要度を分類し、クラウド移行が不可能な社内限定ワークロードを特定する。
- 必要なモデル規模(70B〜200B超)と許容スループット(業務用途であれば15〜30 tokens/secが目安)を算定する。
- Windows Insider PreviewのExperimentalチャネルを検証用PCに導入し、GitHubで公開されたNetworkDirectプロバイダーを用いてUSB4直結の遅延とスループットを実測検証する。
- 単一の大規模サーバー導入見積もりと、USB4クラスタによる調達コスト・消費電力・保守性の比較評価表を作成し、次期の設備投資計画に組み込む。
高価な専用ハードウェアの導入を決定する前に、既存のPCフォームファクタを活用した分散処理の実行可能性を社内ラボで評価することが、無駄な資本支出を抑える確実な一手となります。
出典: エルミタージュ秋葉原
出典: Microsoft Community Hub
出典: PC Watch
出典: エルミタージュ秋葉原(イベント取材)