米セールスフォース(Salesforce)元チーフサイエンティストのRichard Socher氏が率いる米リカーシブ・スーパーインテリジェンス(Recursive Superintelligence, Inc.)は、評価額46億5,000万ドルで6億5,000万ドルを調達し、新著『The Eureka Machine』で科学的発見を自動化する構想を提示した。国内の製薬・素材企業にとっても、武田薬品工業などの大手が進めるウェットラボ主導の創薬パイプラインを、計算資源と自律実験を直結させた発見ループへ切り替えられるかが問われる。
評価額46.5億ドルのRecursive社と自律研究への投資集中
米国の生成AI投資は、チャットボットやコンテンツ生成から、物理世界の科学的課題を解く「AI for Science」と自己改良型システムへ焦点を移している。リカーシブ・スーパーインテリジェンス(Recursive Superintelligence, Inc.)は2026年5月、Alphabet傘下のGV(旧Google Ventures)およびグレイクロフト(Greycroft)が主導するラウンドで6億5,000万ドルを調達した。このラウンドにはエヌビディア(NVIDIA)やアドバンスト・マイクロ・デバイセズ(AMD)の投資部門も参加した。調達時の従業員数は30人未満であり、製品リリース前の段階で企業評価額は46億5,000万ドルに達した。
さらに同社は2026年7月、自律型AI研究システムの運用基盤として、アマゾン・ウェブ・サービス(Amazon Web Services, AWS)と複数年で総額4億1,000万ドルの計算資源利用契約を締結した。同社にはオープンAI(OpenAI)、グーグル・ディープマインド(Google DeepMind)、メタ・フェア(Meta FAIR)出身の研究者が集まり、顧問には元グーグル(Google)研究ディレクターのPeter Norvig氏が就任した。欧州でも2026年5月に英インヒレント(Inherent)が5,000万ドルを調達し、研究再現ベンチマークエージェント「Faraday」を発表するなど、研究開発プロセスの自動化を狙うスタートアップへの資本配分が加速している。
| 企業・プロジェクト | 調達額/契約規模 | 主な出資者・提携先 | 開発領域・主力技術 |
|---|---|---|---|
| Recursive Superintelligence | 6億5,000万ドル(評価額46.5億ドル) | GV, Greycroft, NVIDIA, AMD Ventures | 自己改良型AI、科学的発見自動化基盤 |
| Recursive × AWS | 4億1,000万ドル(コンピュート契約) | Amazon Web Services | 自律型AI研究基盤向けの複数年計算リソース |
| Inherent(英国) | 5,000万ドル(シード) | 欧州主要VC | 科学論文再現エージェント「Faraday」 |
同社CEOのRichard Socher氏は2026年9月22日、書籍『The Eureka Machine: Why AI Is the Key to Unlocking a New Era of Scientific Discoveries』を米パブリックアフェアーズ(PublicAffairs)から刊行した。同著でSocher氏は、世界2,300万人の研究者が5万4,000誌以上の学術誌に論文を寄稿する現状を挙げ、専門領域の細分化が科学進歩のボトルネックになっていると指摘した。人間が網羅できない科学データをモデルが再編することで、今後10年で100年分に匹敵する発見が生み出されると予測している。
参考記事: 自律型AI実験ラボの衝撃|英国ARIAが描く「AI科学者」のロードマップと3つの技術的絶対条件
Eureka Machineの4層構造と「エイリアン仮説」の導出
Socher氏が提唱する「Eureka Machine(発見する機械)」は、仮説生成から検証までをクローズドループで完結させるアーキテクチャである。このシステムは以下の4つの構成要素で成り立つ。
- 人類の知識全体の地図: インターネット、学術論文、特許文書を学習した大規模言語モデル
- 物理現実のモデル: 人工衛星、電子顕微鏡、分光計などのセンサーデータを統合したマルチモーダル基盤
- デジタルツイン・シミュレーション: 物理法則に基づき、数億回から数十億回単位の仮想実験を低コストで実行する環境
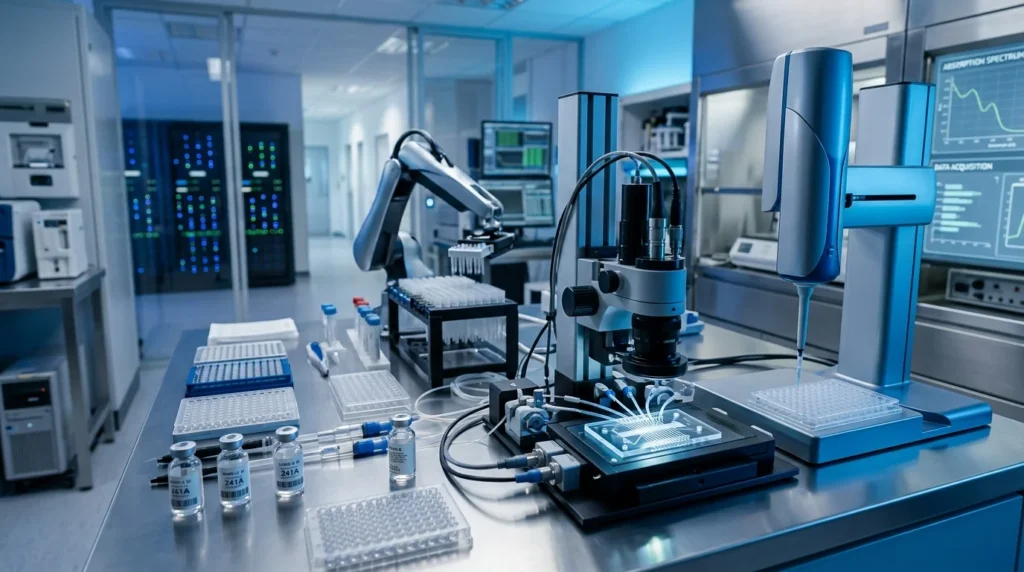
- 完全自律の実験室(セルフドライビング・ラボ): ロボティクスが分注や合成を自動実行し、物理世界の実測値でモデルを修正する設備
[人類の知識地図 (LLM)] ──> [物理現実モデル (センサー)]
           │                            │
           ▼                            ▼
[デジタルツイン・シミュレーション] ──> [自律実験室 (ロボット)]
           │                            │
           └──────< [実測値による自己改良] <──────┘
この基盤が機能する前提には、言語モデルのトークン予測能力が生体分子配列に応用可能になった事実がある。Socher氏らが主導したタンパク質設計モデル「ProGen」は、1万9,000ファミリーに及ぶ2億8,000万件のアミノ酸配列を学習した。アミノ酸の共起関係と文脈を学習した結果、人工設計されたリゾチーム様酵素のうち73%が天然酵素と同等の立体構造を保ち、目標とした抗菌活性を示した。自然界に存在しないアミノ酸配列であっても、モデルは機能発現に必要な立体配置を正確に出力できる。
さらに、仮説立案の領域では米シカゴ大学のJames Evans教授らの研究が実用化の後押しとなっている。Evans氏のチームは約2,000万本の生物医学論文と900万人の研究者の共著関係をネットワーク分析し、既存の学会コミュニティが盲点としている領域を特定した。
人間の研究者は自身の専門領域や既知の知己に依存して仮説を立てる傾向がある。一方、AIは論文群から概念間の空白地帯を探索し、直感に反する「エイリアン仮説」を生成する。1980年代にDon Swanson氏が魚油とレイノー症候群の関係を文献同士の照合から見出した手法を、数千万本の論文規模で機械的に実行する仕組みが確立された。
参考記事: AI創薬による変革の真実|開発期間50%短縮を実現する技術基盤と導入基準
物理実験の速度差と自律実験インフラの課題
Eureka Machine構想が直面する最大の工学的障壁は、仮想シミュレーションと物理検証の間に存在する処理速度の格差である。ミリ秒単位で数百万通りの分子構造を出力できるモデルに対し、現実の化合物合成や生体評価には数日から数週間の時間を要する。
この非対称性を解消するため、Recursive社はまず小型言語モデルの学習効率化やGPUプログラムの自律最適化など、自社のソフトウェア環境内で完結するループから着手している。2026年7月の講演でSocher氏は、特定のカーネル最適化タスクにおいて自社システムが人間のエンジニアが記録した最高効率を上回ったと公表した。ただし、物理世界の化学合成や材料試験を巻き込むには、実験ロボティクスのハードウェア整備が不可欠となる。
自律実験ラボの稼働には、単なる自動分注機にとどまらず、液体の粘性変化や粉体の吸湿性といった物理的揺らぎに対応できるセンサーフィードバック機構が求められる。シミュレーション上で有望と判定された候補物質であっても、現実の合成経路が存在しない、あるいは不純物による失活が起きるケースは多い。物理空間の実験結果をエラーログとしてモデルに再帰入力し、設計モデルを逐次微調整するパイプラインの構築が、商用化における分岐点となる。
参考記事: AI科学研究のボトルネックは検証プロセス|自律実験室の課題と実用化ロードマップ
日本の素材・製薬産業が直面するR&D構造の転換
日本の製造業および製薬企業は、熟練研究者の試行錯誤と実験ノウハウに依拠した研究開発体制を長く強みとしてきた。しかし、海外スタートアップが数億ドル規模の計算資源を投じて仮説生成から自動実験までをシステム化する中、人間依存の実験プロトコルは探索速度の面で劣勢に立たされる。
国内企業が対抗する上での障壁は、電力制約と自律実験装置の調達コストである。Recursive社が締結した4億1,000万ドル規模のコンピュート契約に見られる通り、大規模基盤モデルの事前学習と分子シミュレーションには数千基規模のGPUクラスタを要する。電気料金が高止まりする国内環境において、個別企業が単独で同様の計算インフラを維持することは資本効率上困難である。
また、実験自動化の導入現場では、既存の実験ノートや分析装置がネットワーク化されておらず、非構造化データのまま放置されている事例が多い。ProGenのように数億件のシーケンスを学習させるには、過去の失敗データを含めた標準化フォーマット化が前提となる。
国内の素材・化学メーカーが優位性を保てる領域は、高精度な物性測定データと特殊合成技術の保有にある。計算資源で米巨大資本と競合するのではなく、特定領域の高品質な実験データを入力したドメイン特化型モデルを構築し、外部の自律実験プラットフォームと連携させる戦略が現実的な選択肢となる。
参考記事: 脱レアアース磁石をAIで錬成。米国が進める「量子力学×AI」による次世代永久磁石への挑戦と実用化へのロードマップ
自律研究体制を構築するための実務検証
科学的発見の自動化ループを取り入れるため、研究開発部門は実験データの電子化と自律検証系の接続を段階的に進める必要がある。
1. 過去実験データの機械可読化とネガティブデータの統合
論文や特許に記載された成功事例だけでなく、社内に眠る合成失敗データや物性測定ログを構造化データベースへ移行する。AIが探索空間の境界を正しく認識するためには、反応しなかった実験結果のパラメータ群が不可欠な教師データとなる。
2. オープンソース分子モデルを用いた仮説生成の精度検証
ProGenや類似の生体分子設計モデルを導入し、自社が保有する特定標的タンパク質や機能性ポリマーの設計精度を検証する。汎用モデルが生成した候補物質の合成難易度を自社ウェットラボで測定し、自律探索パイプラインの誤差率を算出する。
3. モジュール型自律実験ロボットのパイロット導入
全自動化を目指すのではなく、化合物の自動分注や分光測定など特定の反復プロセスにロボティクスを導入し、モデルとAPI連携させる。モデルの出力から物理検証、結果の再学習までが人間を介さず循環する最小構成(MVP)を構築し、検証サイクルの短縮効果を測定する。
出典: exawizards.com
出典: hachettebookgroup.com
出典: dealroom.co
出典: kirkusreviews.com