アイオンキュー(IonQ)は2026年9月23日、第6世代QPU「Superion 256」をエヌビディア(NVIDIA)の加速量子研究センターへ直接配備すると発表した。理化学研究所が運用するスーパーコンピュータ「富岳」の後継機計画においても、GPUラックと量子プロセッサを物理的に統合する設計判断が求められる。
NVAQCへの物理直結と2026年のハイブリッド計算市場動向
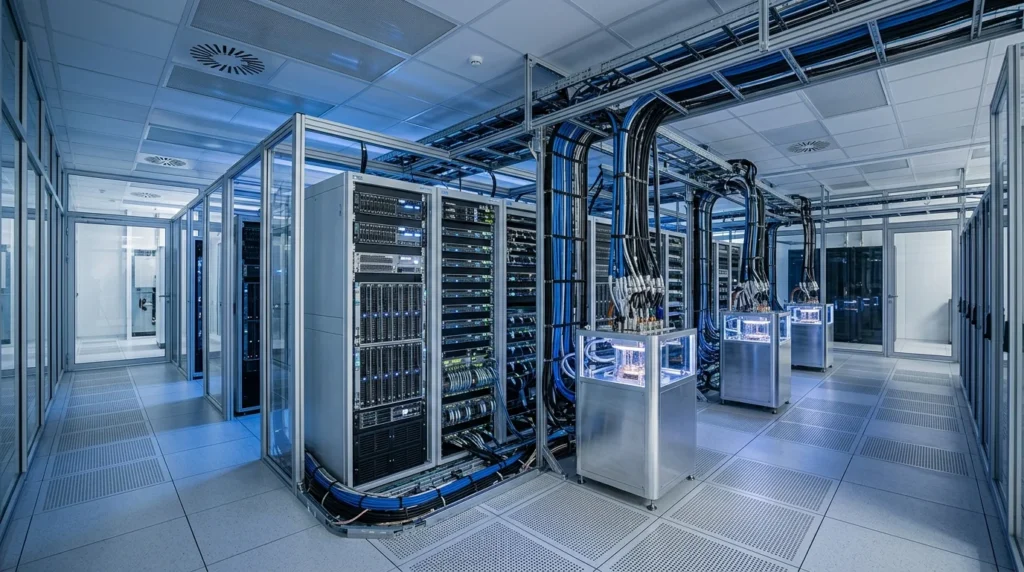
IonQによる「Superion 256」の配備先は、NVIDIAの加速量子研究センター(NVAQC: NVIDIA Accelerated Quantum Research Center)である。商業出荷が予定される2027年に合わせて設置され、同センターにおいて初のオンプレミスQPUとなる。従来主流であったクラウドAPI越しの計算処理モデルから、同一データセンター内でのハードウェア直結モデルへと移行する実証事例である。
NVIDIAの量子ソフトウェア基盤である「CUDA-Q」は、2026年時点で公表されている主要なQPUアーキテクチャの75%と接続可能な状態に達している。今回の提携において資本提携や出資関係は発生していないが、ハードウェア同士のインターコネクト統合により、古典AIインフラと量子計算の結合が進められている。
IonQおよびNVIDIAをめぐる2026年の主要な動きは以下の通りである。
| 年月 | 組織・対象 | 発表・実証の事実 |
|---|---|---|
| 2026年5月 | NVIDIA | ハイブリッドアルゴリズム向け「cudaq-algorithms」ライブラリを公開 |
| 2026年7月 | NVIDIA | 6種類の量子ビット方式に対応する自動キャリブレーションモデルを発表 |
| 2026年9月8日 | IonQ | スカイウォーター(SkyWater)の工場で製造した「Superion 256」を受注開始 |
| 2026年9月14日 | NVIDIA | 耐障害性量子計算(FTQC)向け「CUDA-Q Logical」をオープンソース公開 |
| 2026年9月22日 | IonQ | 単一の市販CPU上で動作するリアルタイム量子誤り訂正デコーダーの実証を発表 |
| 2026年9月23日 | IonQ / NVIDIA | NVAQCへのSuperion 256配備とNVQLinkによる直接ハードウェア接続を発表 |
IonQの財務状況をみると、2026年第2四半期売上高は前年同期比約286.7%増を記録した。受託製造企業であるスカイウォーター・テクノロジー(SkyWater Technology)の買収に伴い、2026年通期の売上高ガイダンスを4億5,000万ドル(約675億円)以上に引き上げている。年間純損失は約5億1,038万ドルを計上しているものの、長期負債ゼロかつ流動比率約10.66という手元流動性を維持し、設備投資を継続している。発表当日の株式市場では、IonQ株が一時13%急騰したほか、リゲッティ・コンピューティング(Rigetti Computing)などの同業銘柄も約7%連れ高となった。
参考記事: オラクルとQuantinuum、クラウド量子コンピューティング提供で複数年契約を締結
NVQLinkとCUDA-Qが打破する通信遅延の壁
今回のシステム構成における中核は、IonQの256量子ビットQPUと、NVIDIAのラック規模システム「GB200 NVL72」を「NVIDIA NVQLink」で直結する点にある。オーケストレーションはオープンソース基盤のCUDA-Qが担う。
従来型のクラウド接続アプローチでは、HTTPSベースのAPIを介するため、ネットワーク遅延が数十ミリ秒から数百ミリ秒発生していた。この遅延は、反復的なパラメータ更新を必要とする変分量子固有値ソルバー(VQE)や量子近似最適化アルゴリズム(QAOA)において致命的な計算オーバーヘッドとなっていた。NVQLinkによる物理的な相互接続は、GPUクラスタと量子制御ハードウェア間の通信をマイクロ秒オーダーに短縮する。
イオントラップ方式のQPUは、超伝導方式と比較してゲート忠実度が高い一方、ゲート操作時間がマイクロ秒オーダーと比較的緩慢である。古典計算側のデコードやフィードバックが遅延すると、量子コヒーレンス時間が尽きる問題があった。今回の直結アーキテクチャでは、2026年9月22日にIonQが発表した標準CPU向けリアルタイム誤り訂正デコーダーと、GB200の計算能力を近接配置することで、物理量子ビットから論理量子ビットへのシームレスな症候測定(シンドローム測定)と訂正ループを成立させる前提条件を整えている。
また、Superion 256はSkyWaterのCMOS半導体ファウンドリを活用して製造されており、チップレベルでの集積化と再現性を担保している。真空装置や光学系をモジュール化し、標準的なデータセンターラックに収容可能なフォームファクタを実現したことが、研究施設内のGPUラック直結を技術的に可能にした要因である。
参考記事: 【2027年FTQC実用化】Infleqtion『Sqale』とNVIDIA NVQLinkがもたらす量子・GPU密結合の全貌
国内HPC基盤とデータセンター選定への影響
NVAQCの事例は、日本のハイパフォーマンス・コンピューティング(HPC)およびAIインフラ戦略に対して直接的な再考を迫る。文部科学省が進める次世代フラッグシップシステム(通称「Fugaku-NEXT」)の基本設計検討や、産業技術総合研究所(産総研)の「ABCI」などの共同利用拠点では、アクセラレータクラスタと量子デバイスの共コロケーション(同一建屋・同一ラック群への配置)が現実的な検討課題となる。
これまで国内の量子アルゴリズム検証は、AWSやAzureなどの海外メガクラウドを経由したアクセスが主力を占めていた。しかし、NVQLinkのような専用インターコネクトを介した密結合環境が標準化すると、ネットワーク越しでのアルゴリズム開発は研究開発スピードにおいて不利になる。
日本の産業界にとっての優位性は、光通信やインターコネクトの要素技術にある。GPUラックとQPUの間を光ファイバーやコパッケージドオプティクス(CPO)で直結する実装において、国内電子部品・光通信機器メーカーの低損失光コネクタやシリコンフォトニクス技術の需要が高まる。一方で、既存の国内データセンターは床耐荷重や液体冷却(液冷)設備、電磁シールド環境において量子プロセッサの併設を想定していない施設が大半である。QPU用の冷凍機や真空制御ラックを受け入れるインフラ改修が、設備調達上の障壁となる。
参考記事: [量子クラウドサービスの選定基準と導入ロードマップ|主要プラットフォーム比較からセキュリティ、国内環境まで徹底解説](https://techshift.jp/glossary/%e9%87%8f%e5%ad%90%e3%82%af%e3%83%a9%e3%82%a6%e3%83%89%e3%82%b5%e3%83%bc%e3%83%93%e3%82%b9/
計算基盤の刷新に向けた技術的アクション
量子古典ハイブリッド計算の検証を進める研究機関およびエンタープライズの技術責任者は、次の3点に焦点を当てて準備を進める必要がある。
- アルゴリズム評価軸を「物理遅延込みの処理時間」へ再定義する。クラウドAPI経由のレイテンシを前提としたコード体系から、メモリ共有や直接DMA転送を想定した低遅延パイプラインの設計へ切り替える。
- 開発環境をCUDA-Qなどのヘテロジニアス標準へ統一する。特定の量子ハードウェア専用SDKへのロックインを避け、GPUとQPUを同一コード内で記述できるフレームワークでの実装資産を蓄積する。
- 自社データセンターおよび契約先拠点の物理受け入れ仕様を精査する。将来的にオンプレミスQPUをGPUクラスタに増設する場合、消費電力、液冷配管、耐震免震構造、光配線トポロジーの適合性を事前検証しておく。
出典: Quantum Business Magazine
出典: IonQ News
出典: NVIDIA Developer
出典: Quantum Zeitgeist