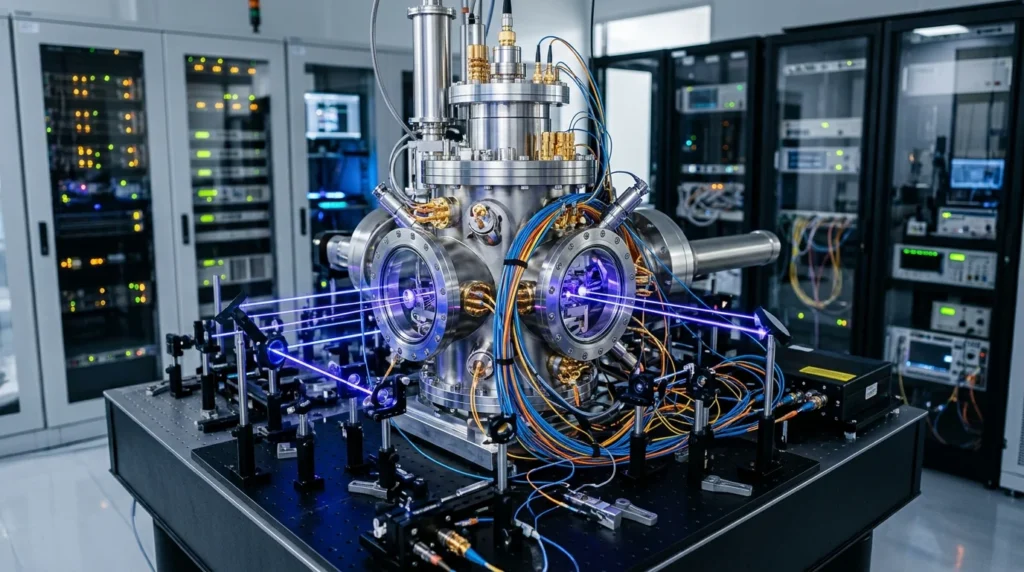
理化学研究所とクオンティニュアムは2026年11月10日、理研和光キャンパスに設置されたイオントラップ型量子コンピューター「黎明」の性能強化を完了し、正式に稼働を開始しました。物理量子ビット数を従来世代から約3倍となる56個へ拡張し、GPUスーパーコンピューター「ROQUO」との連携によって量子サンプリングデータをAI学習に直接供給する基盤を確立しています。
「黎明」System Model H2への刷新とJHPC-quantumの進展
今回のシステム改修は、理化学研究所(理研)和光キャンパスに導入されているイオントラップ型量子コンピューター「黎明」を、クオンティニュアムの最新アーキテクチャ「System Model H2」へと更新したものです。新エネルギー・産業技術総合開発機構(NEDO)が推進する「JHPC-quantum」プロジェクトの中核計算機として、日本の先端計算インフラにおける実用検証を推進します。
「黎明」は2025年2月の稼働開始当初、前世代の「System Model H1」をベースとした20物理量子ビットの構成で運用されていました。今回の更新により、物理量子ビット数は56量子ビットへと大幅に増加しました。
あわせて理研計算科学研究センター(兵庫県神戸市)に整備されたGPUスーパーコンピューター「ROQUO(ろっこう)」との連携運用が本格化しています。スーパーコンピューター「富岳」とのCPU連携に加え、ROQUOのGPUクラスタを組み合わせた3層のハイブリッド計算アーキテクチャが稼働を開始しました。
ハードウェア仕様と主要コンポーネントの比較
「黎明」の更新前後の性能と、連携するスーパーコンピューターの仕様は以下の通りです。
| システム名 | アーキテクチャ / 搭載プロセッサ | 計算規模 / 量子ビット数 | 特徴・結合性 |
|---|---|---|---|
| 黎明(更新前・H1) | イオントラップ型(Yb+ / Ba+) | 20物理量子ビット | シャトル方式・全結合接続 |
| 黎明(更新後・H2) | イオントラップ型(Yb+ / Ba+) | 56物理量子ビット | レーストラック型トラップ・全結合接続 |
| ROQUO(ろっこう) | NVIDIA Blackwell GPU / Grace CPU | 540基のGPU / 270基のCPU | 実測FP64性能 19.80 PFLOPS |
プロジェクトの変遷と連携体制
本システムの高度化に至る経緯と関連組織の動向を整理します。
- 2024年6月: 米クオンティニュアムが56量子ビットを搭載した「System Model H2-1」を世界発表。JPMorgan Chaseとの共同研究でランダム回路サンプリングベンチマークを実施。
- 2025年2月: 理研和光キャンパスにて「黎明」(20量子ビット)がJHPC-quantum事業の一環として運用開始。
- 2025年9月: ソフトバンクと理研が学術情報ネットワーク「SINET」経由でAI計算基盤と量子コンピューターの相互接続を開始すると発表(翌10月より開始)。
- 2026年6月: 理研計算科学研究センターにて、NVIDIA GB200 NVL4ノードを採用したGPUスーパーコンピューター「ROQUO」が運用開始。
- 2026年11月: 黎明のSystem Model H2(56量子ビット)への改修が完了。ソフトバンクを含む3者でAIデータセンター連携の覚書(MOU)を締結。
参考記事: 量子コンピュータとは?仕組みからビジネス活用・2030年実用化シナリオまで徹底解説
全結合イオントラップとGPUクラスタ「ROQUO」の技術的構造
今回の更新における技術的本質は、単なるビット数の増加にとどまりません。イオントラップ方式が持つ「全結合性」を56量子ビット規模で維持した点、およびその出力をBlackwell世代のGPUクラスタに直結させた点にあります。
イオントラップ型「全結合(All-to-All Connectivity)」の強み
超伝導方式の量子コンピューターでは、量子ビットはシリコン基板上に平面的に配置されます。そのため、隣接するビット同士しか直接相互作用させることができません。遠隔の量子ビット間で2量子ビットゲート操作を実行する場合、多数のSWAPゲートを連続して適用する必要があります。この回路深度の増加は、ゲートエラーの蓄積とコヒーレンス消失を招く要因となります。
クオンティニュアムのSystem Model H2は、レーストラック型の真空イオントラップ構造を採用しています。荷電粒子であるイッテルビウム(Yb+)イオンとバリウム(Ba+)イオンをマイクロ加工電極による電場トラップ内に捕捉し、シャトリング(移動)技術を用いて物理的に目的の位置へ運搬します。レーザー光を照射して2量子ビットゲートを適用するため、任意の2つの量子ビット間でSWAPゲートを挟まずに直接ゲート操作を実行できます。
56量子ビットの全結合環境下では、2量子ビットの組み合わせは1,540通りに上ります。超伝導方式で同等の回路を組む場合と比較して、必要なゲート総数を大幅に削減可能です。回路の浅さは、量子多体系のシミュレーションにおいて忠実度を保つ上で決定的な優位性をもたらします。
量子サンプリングとGPU AIモデルの協調パイプライン
「黎明」とGPUスーパーコンピューター「ROQUO」の連携では、量子サンプリングデータをAIモデルの学習データセットとして直接組み込むパイプラインが構築されています。
ROQUOは135台のNVIDIA GB200 NVL4ノードを備え、540基のNVIDIA Blackwell GPUと270基のNVIDIA Grace CPUで構成されています。Linpackベンチマーク(HPL)における倍精度(FP64)実測性能は19.80 PFLOPSに達します。この大規模GPU環境上で動作するAIモデルに対し、黎明から高精度な量子相関データが注入されます。
従来の古典シミュレータでは、強相関電子系や磁性体の基底状態を計算する際に「指数の壁」に直面していました。系のサイズが大きくなるにつれてヒルベルト空間の次元が指数関数的に増大するためです。サンプリング近似に頼ると古典計算ではバイアスや打ち切り誤差が生じます。
黎明のSystem Model H2が直接サンプリングした量子もつれ状態の分布データをROQUO上のAIモデルに事前学習させることで、モデルは物理制約を正確に反映した潜在表現を獲得できます。初期の磁性体シミュレーション検証において、古典計算データのみで学習したAIモデルの予測精度を上回る結果が得られています。
FTQC(誤り耐性量子計算)到達に向けた技術的必須条件
56個の物理量子ビットの実装は、NISQ(ノイズあり中規模量子)の限界を越え、誤り訂正を伴うFTQCへの布石となります。
量子誤り訂正を実現するためには、物理エラー率が誤り訂正符号のフォールトトレラント閾値を下回る必要があります。クオンティニュアムのシステムは、2量子ビットゲート忠実度において99.9%を達成しています。カラーコード(Color Code)などのフォールトトレラント符号を適用し、複数の物理量子ビットから論理量子ビットを合成する実験が進められています。
56ビット環境下では、複数の論理量子ビットをエンコードし、誤り訂正回路を回しながら計算を実行する「論理回路」の実装が現実的なスケールに入ります。今回の改修は、単なるサンプラーとしての機能だけでなく、論理量子ビット間でのエンタングルメント操作検証に向けたプラットフォームとしての条件を満たしています。
参考記事: 量子誤り訂正の基礎からFTQC実現へのロードマップ|最新の実証データと開発戦略まで徹底解説
参考記事: GPUクラスタの仕組みと構築戦略|CTOが押さえるべき最前線と2030年の未来
量子ハードウェア・フロンティアAI・通信インフラへの波及
56量子ビット全結合マシンとGPUクラスタの直接連携は、関連する産業セグメントのアーキテクチャ設計に多面的な影響を与えています。
1. 量子ハードウェア企業:忠実度と結合性を軸とした競争へのシフト
従来の量子コンピューティング開発では、物理量子ビット数の多さ(100ビット、1,000ビット等の数値)が指標として強調されてきました。超伝導方式は集積度で先行する一方、クロストークノイズの抑制や配線の複雑化という課題を抱えています。
イオントラップ方式が56ビットの全結合と高いゲート忠実度を実証したことで、ハードウェアの評価基準は「物理ビット数」から「アルゴリズムを実行可能な有効量子体積(Quantum Volume)」および「全結合を活用した回路の浅さ」へと移行しています。中性原子方式やシリコン方式を展開するハードウェアベンダーも、単なる格子状配列から長距離エンタングルメントや原子シャトリングの実装へ舵を切る必要があります。
2. AIモデル開発企業(フロンティアラボ):量子データインジェクションの標準化
大規模言語モデル(LLM)や科学計算用ファウンデーションモデルを開発するフロンティアラボにとって、古典シミュレーションデータのみを用いた学習パイプラインは限界を迎えつつあります。特に触媒反応、分子間相互作用、スピントロニクス材料などの予測において、古典近似データに起因する幻覚(ハルシネーション)や物理法則との乖離が問題視されてきました。
量子サンプリングデータを特徴量空間の正則化や事前学習コーパスとして組み込む「Quantum-Informed AI」のアプローチは、モデルの汎化性能を押し上げる実証段階へ入りました。計算創薬や新材料開発に特化したAI開発企業は、量子プロセッサをコプロセッサとしてAPI経由でパイプラインに組み込む設計を迫られています。
3. 通信キャリア:ハイブリッドデータセンターの商用インフラ運用
今回の発表において、理研とクオンティニュアムに加えてソフトバンクが戦略的提携(MOU)に加わった点は、通信インフラ事業者の役割変化を反映しています。
通信事業者はこれまで、高速光ファイバー網や学術情報ネットワーク(SINET)の帯域提供にとどまっていました。量子コンピューターを実用インフラへ組み込むためには、極低温・超高真空環境を維持する特殊設備、低遅延な制御ネットワーク、そしてGPUクラスタを同一拠点または近接データセンター内で統合運用する技術が求められます。通信キャリア各社は、自社の次世代AIデータセンター内に量子計算基盤を抱え込み、従量課金型のハイブリッド計算リソースとしてエンタープライズに提供する事業モデルの構築を進めています。
参考記事: 量子優位性とは?量子超越性・ユーティリティとの違いと2030年までの導入ロードマップ
TechShiftの視点:量子サンプリングが変える計算資源の投資判断
「黎明」の56量子ビット化とROQUO連携は、量子コンピューティングの導入評価軸を「単独での優位性証明」から「AIパイプラインへの性能寄与度」へと転換させました。
技術責任者および投資家が今後注視すべき評価基準は、公称ビット数ではなく以下の定量的KPIです。
- 量子サンプリングによるAI予測誤差の低減率: 古典モンテカルロ法等で生成した学習データと比較し、量子サンプラーの出力を組み込んだモデルがテストデータ(DFT実測値や実験値)に対して二乗平均平方根誤差(RMSE)を何%改善できたか。磁性・触媒解析において15%以上の精度向上が安定して得られるかどうかが投資継続の分岐点となります。
- 2量子ビットゲート実行時の実効レイテンシとスループット: イオントラップ方式の弱点とされてきたイオン移動(シャトリング)時間は、ミリ秒オーダーからサブミリ秒へと短縮が進んでいます。Blackwellノードの高速イテレーションに追従するため、1秒間にサンプリング可能なショット数が1,000〜10,000ショットのオーダーを安定して維持できるかが、実務導入のGOサインとなります。
- 論理エラー抑制ファクター(Physical-to-Logical Error Ratio): 56物理ビットを用いて単一または複数の論理量子ビットを構築した際、物理ゲートエラー率(約10^-3)に対して論理ゲートエラー率が10倍以上抑制されているか。この数値が確認できた段階で、2028〜2029年の商用データセンター導入に向けたハードウェア調達リスクは劇的に低下します。
産業応用の観点では、2029年の商用化ターゲットを待つことなく、材料探索・バイオインフォマティクス領域でのPoC(概念実証)を直ちに組み直す局面に来ています。古典スパコンの限界により断念していた100原子規模の量子相互作用モデリングに対し、全結合56ビットの黎明とROQUOの組み合わせを前提としたアルゴリズム設計に着手することが、競争力を左右します。
参考記事: バイオシミュレーションとは?IT創薬の基礎から最先端AI・スパコン活用まで徹底解説
実装ロードマップと技術責任者が着手すべき移行手順
量子とAIの協調アーキテクチャが稼働を開始した現在、研究開発部門やインフラ設計の責任者が着手すべき具体的な手順を整理します。
- 自社における材料・物性探索パイプラインのボトルネック特定
古典密度汎関数理論(DFT)計算や量子モンテカルロシミュレーションで数日以上を要している強相関系タスクを抽出し、サンプリング入力による精度改善が見込める領域を定量化します。
- 全結合アーキテクチャを前提とした量子回路コンパイルの再検証
格子状配置を前提に設計されていた既存の量子アルゴリズムを、全結合接続に最適化されたトランスパイラ(TKET等)を用いて再コンパイルし、回路深度とSWAPオーバーヘッドの削減幅を測定します。
- GPUクラスタと量子APIの非同期データパイプライン設計
ROQUOのようなアクセラレータ環境と量子計算ノード間の低遅延通信プロトコルを検証し、バッチ処理でのサンプリングデータ受け渡しがAIモデルの学習ループを阻害しないインターフェース仕様を固めます。
出典: ヤフーニュース(ビジネス+IT)
出典: 理化学研究所 プレスリリース
出典: クオンティニュアム プレスリリース
出典: PC Watch
出典: PR TIMES