中国のAIスタートアップであるディープシーク(DeepSeek)と華為技術(Huawei Technologies)は2026年9月30日、エヌビディア(NVIDIA)のCUDAコードと1対1で対応するオープンソース言語「TileLang」および計算ライブラリ群を公開しました。国内でさくらインターネットなどが進める経済安全保障推進法に基づくAI計算基盤の整備において、特定GPUエコシステムへの依存度をどう抑制するかという判断に直結する動きです。
米国規制下で進む中国国産スタックの台頭と投資動向
ディープシークと華為技術の協業は、米商務省産業安全保障局(BIS)による先端半導体の輸出規制が長期化する中で進展しました。ディープシークは社内の計算リソースの70%以上をモデル学習に割り当てており、2026年に入り従来のNVIDIA H800搭載システムから華為製プロセッサー「Ascend」への移行を加速させています。
内モンゴル自治区烏蘭察布(ウランチャブ)では、華為の「Ascend 950DT」プロセッサーを少なくとも16万基導入する1GW規模のデータセンター建設計画が進んでいます。中国製AIアクセラレーターを採用した単一プロジェクトとしては過去最大級の取り組みの一つとされています。
華為技術は2026年9月17日の「Huawei Connect 2026」において、輪番会長の汪涛(David Wang)氏が次世代チップ「Ascend 960DT」の出荷時期を2027年第1四半期へ3四半期前倒しすると発表しました。同時に最大100万基のチップを相互接続する「UnifiedBus」技術のロードマップも示されています。
以下の表は、ディープシークと華為技術を巡る主な動きと技術展開の時系列です。
| 時期 | 実施主体 | 発表・実施内容 |
|---|---|---|
| 2025年9月 | DeepSeek | Ascendアーキテクチャ向けDSL「TileLang-Ascend」初期版を公開 |
| 2026年6月 | DeepSeek | 約500億元の外部資金調達を完了(評価額500億ドル超) |
| 2026年9月上旬 | DeepSeek | 内モンゴルに16万基超のAscend 950DTを備えるDC建設計画が報道 |
| 2026年9月中旬 | 華為技術 | Ascend 960DTの出荷を2027年Q1へ前倒し、UnifiedBusを発表 |
| 2026年9月30日 | 両社 | TileLangおよび計算・通信ライブラリ群をオープンソース公開 |
資本面では、ディープシークは約500億元(約75億ドル)規模となる2回目の資金調達ラウンドの完了に近づいており、これにより企業評価額は約740億ドルに達する見込みです。同社は中信証券(CITIC Securities)を起用し、上海証券取引所の科創板(STAR Market)へのIPO(新規公開株式)準備を進めています。2026年1〜7月の売上高は約4億7,500万元、純損失は約7億1,500万元を計上し、年間換算売上高は10億ドル規模に達しています。
一方、NVIDIAは750万人以上のCUDA開発者を抱え強固なエコシステムを維持していますが、SEC(米証券取引委員会)提出書類において、中国市場からの締め出しが競合による代替エコシステムの育成を助長している旨のリスクを記載しています。
参考記事: DeepSeekの1兆円調達が示すAIアーキテクチャの転換|8兆円評価を支える技術と実装ロードマップ
TileLangとAscend 950が実現するハードウェア抽象化の仕組み
今回公開されたオープンソースパッケージの中核は、ハードウェアの性能クリティカルなカーネルを記述するための高水準プログラミング言語「TileLang」です。本言語は華為のAIアクセラレーター「Ascend 950」に正式対応し、ネイティブコード生成、自動スケジューリング、同期機能を備えています。
最大の特徴は、NVIDIAハードウェア向けに記述された既存コードと1対1で対応する点です。基盤層の実装をランタイムが自動選択し、上位層のAPIインターフェースを維持することで、開発者はコードの書き換え摩擦なしにNVIDIA環境からAscend環境へ移行できます。
パッケージには言語本体に加え、モデル学習と推論に必要な計算・通信ライブラリ群が同梱されています。
| ライブラリ名 | 担う機能・処理領域 | 互換・代替対象の処理 |
|---|---|---|
| DeepGEMM | 行列積演算(GEMM)の高速化 | NVIDIA cuBLAS / CUTLASS |
| DeepEP | デバイス間通信(MoEエキスパート並列) | NVIDIA NCCLベースの通信処理 |
| TileKernels | ベクトル演算およびオンチップメモリアクセス | カスタムCUDAカーネル |
| FlashMLA | マルチヘッド・レイテント・アテンション処理 | 長文脈処理向けFlashAttention |
| DeepSelect | 効率的なデータフィルタリングと選択 | 前処理・動的トークンルーティング |
ディープシークが開発した最新モデル「V4-Flash」は、設計段階から華為のAscendプロセッサーネイティブで構築されています。従来のGPU向けコードをトランスパイルするアプローチでは、メモリ帯域や並列演算ユニットの構造差によってハードウェアの理論性能を引き出せない問題がありました。TileLangはタイル単位のメモリアロケーションと演算スケジューリングを抽象化し、Ascend特有のNPUアーキテクチャに直接マッピングすることでこのボトルネックを解消しています。
さらに両社は、128基のAscend 950チップを相互接続する「スーパーノード」システムを共同開発しました。計算ユニット間およびノード間の通信オーバーヘッドを低減し、テストケースにおいてハードウェアの性能限界値に近いスループットを記録しています。華為はこれまでにスーパーノードシステムを370社以上の顧客へ1,000台以上出荷しており、月間アクティブ開発者数は5,270名に達しています。
参考記事: DeepSeekのAGIロードマップとは?Huawei製AIチップとTileLangでNVIDIA依存を脱却できる…
参考記事: DeepSeek-V4-Flashの仕組みと影響|AIデータセンター構造を変革する推論最適化のロードマップ
国内AIインフラと計算基盤戦略への直接的な影響
ディープシークと華為の取り組みは、日本国内でAIインフラを構築するクラウド事業者や大規模モデル開発企業に対して、計算基盤の二重化という技術的示唆を与えます。
現在、日本国内の大規模基盤モデル開発はNVIDIA製GPU(H100やB200など)とCUDAスタックへの依存度が極めて高い状態にあります。経済産業省が支援する計算基盤整備においても特定ハードウェアへの集中が続いており、調達リードタイムの長期化やライセンス費用の高止まりが開発コストを圧迫しています。
TileLangのようなハードウェア抽象化レイヤーの成熟は、特定ベンダーのマイクロアーキテクチャに縛られないモデル開発の実効性を示しています。国内企業にとって、現時点でAscendハードウェアそのものを導入することは地政学的リスクや調達規制の観点から非現実的です。しかし、PyTorchなどのフレームワーク層とハードウェア層の間にオープンソースのカーネル記述言語を挟むアプローチは、マルチベンダー戦略を採る上で有用な知見となります。
国内で導入を検討する際の主な構造的ハードルは以下の通りです。
- ソフトウェア検証コスト: 既存のMLOpsパイプラインやデバッグ環境はCUDAを前提に構築されており、新しい抽象化レイヤーを採用する場合、数値精度検証や分散学習の障害切り分けに専門人材が必要となります。
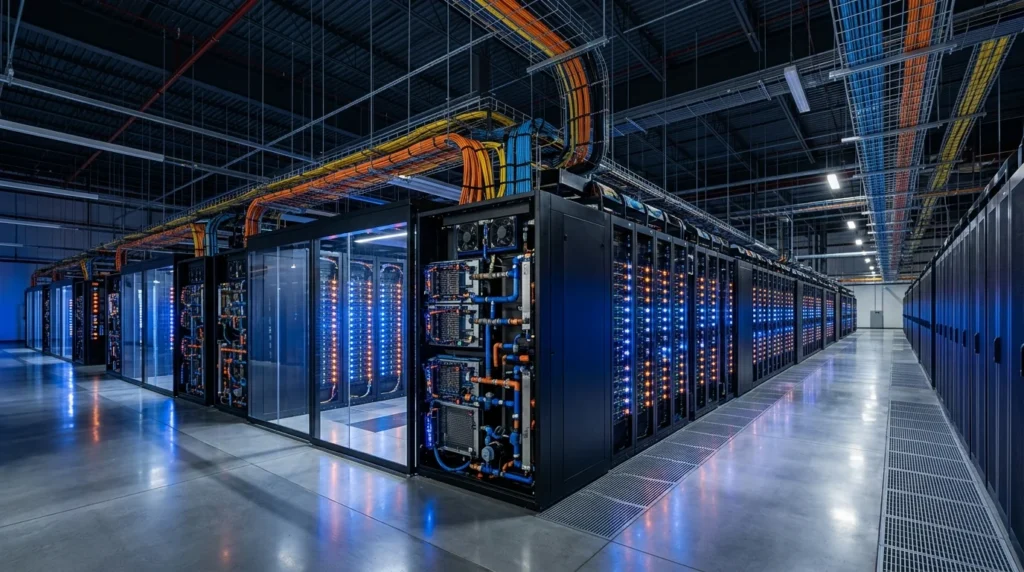
- データセンターの設備制約: 128基規模のスーパーノード構成や将来の超高密度クラスターを稼働させるには、高電圧受電設備や液冷ラックへの刷新が不可欠であり、既存の空冷データセンターでは電力密度の上限に直面します。
- 開発コミュニティの規模差: CUDAの750万人超の開発者規模に対し、代替ツールのエコシステムは立ち上がったばかりであり、ライブラリのバグ修正やエッジケース対応のスピードには依然として開きがあります。
参考記事: 大規模言語モデル大手がNVIDIAから集団「離反」:OpenAIやDeepSeekが自社製推論チップ(ASIC)へ…
技術責任者・投資家が検証すべき次のアクション
特定ベンダーのGPU環境を前提としたアーキテクチャ設計から脱却するため、技術責任者およびインフラ担当者は以下の実務的検証に着手する必要があります。
- カーネル依存コードの棚卸しと抽象化レイヤーのPoC
自社で開発・運用しているAIモデルの学習・推論コードにおいて、CUTLASSやNCCLなどのCUDA固有ライブラリに直結している箇所を特定します。その上で、TileLangやOpenAI Tritonのような中間言語を用いた実装への置き換えを行い、カーネルのコンパイルオーバーヘッドと実行効率を定量測定します。
- クラスタ構成における通信ボトルネックの再評価
チップ単体のFLOPS値だけでなく、128基規模のノード間を接続するネットワークファブリック(UnifiedBusや独自インターコネクト)の通信帯域とレイテンシを検証します。特にMoE(Mixture of Experts)モデルを運用する場合、DeepEPのような分散通信最適化ライブラリがネットワークインターフェイスカード(NIC)やスイッチの要件にどう影響するかを再算定します。
- マルチハードウェアを前提とした調達ポートフォリオの策定
推論ワークロードを中心に、汎用GPU以外の選択肢(各種AIアクセラレーターや推論特化型ASIC)を組み込んだインフラ調達計画をシミュレーションします。ハードウェアの移行コストをソフトウェア抽象化によって極小化できる体制を整えることが、長期的な計算コストの削減と供給途絶リスクのヘッジにつながります。
出典: finance.biggo.jp
出典: scmp.com
出典: github.com
出典: technode.com